PUBG 黑货箱奖池怎么选?开箱模拟器
PUBG 黑货箱奖池怎么选?开箱模拟器
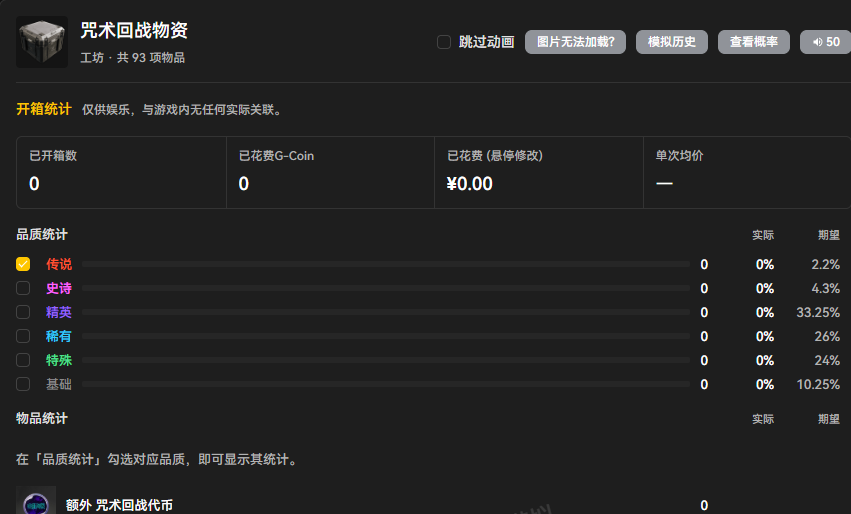
大多数开箱讨论聚焦在“这个箱子爆率多少”,但黑货箱的实际设计比这更复杂一层:同一个黑货箱下挂多个奖池,每个奖池的概率结构并不相同。 玩家在开箱之前做出的“选哪个奖池”的决策,本质上是在选择一套不同的概率分布,而不仅仅是在选“我想要哪把枪的皮肤”。模拟器的价值在这里被低估了——它不只是用来“试手气”,更是用来在多个奖池之间做结构性比较的工具。
四个奖池,四套概率结构
根据玩家社区对黑货箱四个奖池的统计,以“破碎元素”和“剧变熔岩”这一组为例:两个奖池的金色概率均为 6.30%,银色均为 38.35%,黑色均为 55.35%,图纸(金)均为 1.80%,聚合物(黑)均为 18.15%。表面上看,这组奖池的概率结构完全一致。但另一组奖池的概率分布有所不同:金为 5%,银为 41.80%,黑为 53.20%,图纸(金)为 0.90%,聚合物(黑)为 13.30%。差异集中在两个地方:金色概率低了 1.3 个百分点,但银色概率高了 3.45 个百分点,图纸概率腰斩,聚合物概率也明显下降。-10
这意味着选择奖池时面临的是一个多目标权衡,而不是单一维度的“出金率高低”。如果你追求的是“出金”(任何金色物品),6.30% 的奖池在理论上更有优势。但如果你同时关心图纸和聚合物的积累——这两者是成长型武器升级的核心材料——那么图纸概率 1.80% 对 0.90% 的差距,在长期开箱中会产生实质性的资源积累差异。社区统计的结论也印证了这一点:破碎元素和剧变熔岩“出金率最高但同时获得图纸和聚合物的概率也是最高”,而另一个奖池则在银色物品的产出上更密集。-10
蒙特卡洛模拟给出的不是“爆率”,是分布的形状
只看单次概率,很容易把奖池选择简化为“哪个数字大选哪个”。蒙特卡洛模拟提供的视角完全不同:它不告诉你“单次出金的概率是多少”,它告诉你在跑完 N 次开箱之后,出货次数的分布是什么形状。
一个标准的开箱模拟工具会输出至少四个统计量:均值(所有模拟轮次的平均出货次数)、中位数(50% 的模拟轮次在这个次数之内出了货)、95 分位数(运气最差的 5% 需要多少次),以及最小/最大值区间。这四个数字合在一起,才构成一个奖池的“概率画像”。以两个金色概率分别为 6.30% 和 5% 的奖池为例:均值和中位数会给出“典型情况下差多少次”,95 分位数则回答一个更实际的问题——“如果我运气不太好,选这个奖池比选那个奖池多花多少次才能出金”。均值告诉你期望,中位数告诉你典型体验,95 分位数告诉你尾部风险。 只看单次概率,你看不到尾部。-36
模拟器的另一个关键设定是:它按固定权重、每次独立的方式运行——每个物品的概率等于其权重除以所有权重之和,奖池不随开箱次数变化,不存在“抽得越多概率越高”的隐藏机制。这与 PUBG 黑货箱官方公示的独立概率逻辑是一致的。如果一个模拟器引入了“保底递增”或“移除已掉落物品”的机制,它模拟的就已经不是黑货箱了。-36
样本量决定了你“看到”的概率是否可信
一个 6.30% 的概率,在 10 次开箱中可能一次都不出现,也可能出现两次。这不是系统在“针对你”,这是小样本的正常波动。根据二项分布的标准误公式,对于概率 p、样本量 n 的随机变量,实测比例的标准误约为 √(p(1−p)/n)。以 6.30% 为例,开 100 次时标准误约为 2.4 个百分点,也就是说实测出金率落在 3.9% 到 8.7% 之间都属于正常范围;开 1000 次时标准误收窄到约 0.77 个百分点,实测值才逐渐逼近理论值。-42
这个统计事实对奖池选择有直接影响:如果你想用实测数据来验证“某个奖池是否真的比另一个好”,几十次的开箱记录在统计上没有区分能力。 两个奖池金色概率相差 1.3 个百分点,在数百次样本的噪声中可能完全被淹没。模拟器的用途恰恰在这里:它可以在几秒钟内跑完数千次虚拟开箱,让你看到在足够大的样本下,两个奖池的分布差异是否稳定存在,而不是被几十次真实开箱的随机波动牵着走。
奖池选择的决策框架
把以上几点整合起来,奖池选择可以拆成三个问题,按顺序回答。
第一,你的目标是单一物品还是资源积累? 如果目标是一把特定的枪械皮肤,直接看该皮肤在奖池中的个体概率,而不是奖池整体的“金率”。如果目标是图纸和聚合物的长期积累(为成长型武器升级服务),图纸概率 1.80% 的奖池和 0.90% 的奖池之间的差距,在数百次开箱的尺度上会变得显著。
第二,你愿意承担多大的尾部风险? 95 分位数回答的是“运气不好的那 5% 需要多少次”。两个奖池的均值可能接近,但尾部可能拉开差距。模拟器的 95 分位输出比均值更贴近真实体验的糟糕一端。
第三,你准备投入的样本量是否足以让概率“生效”? 如果预算只够几十次开箱,那么奖池之间的概率差异在统计上几乎不可分辨,此时选择哪个奖池更多是在选“我想要哪组皮肤”,而不是在做一个概率优势决策。模拟器可以帮你确认这一点:用你实际的预算次数去跑模拟,看看两个奖池的输出分布是否重叠到无法区分。
